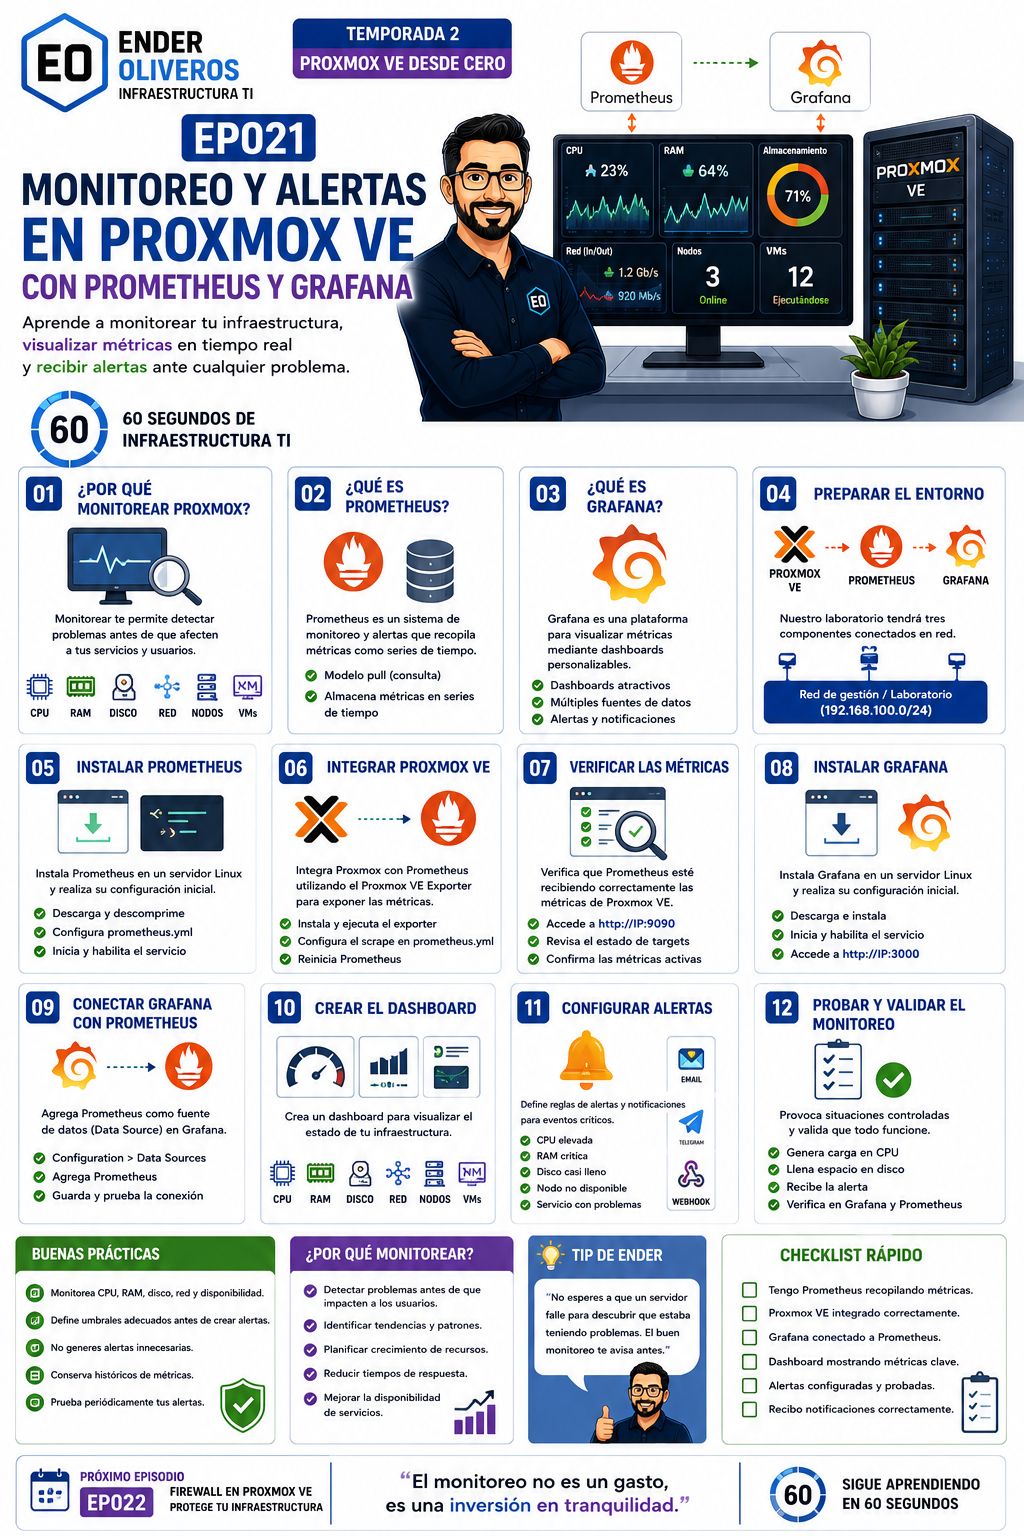
Monitorear no consiste en mirar un panel cuando algo ya falló. Consiste en recoger métricas con frecuencia, conservar su histórico, visualizar tendencias y activar alertas que permitan actuar antes de que un problema afecte a los usuarios.
1. Qué problema resuelve el monitoreo de Proxmox VE
En un clúster virtualizado, la causa visible de un incidente puede estar en el host, una VM, el almacenamiento o la red. Un tablero histórico ayuda a distinguir saturación puntual de una tendencia: memoria que crece cada día, disco que se llena, latencia que aumenta o un nodo que deja de reportar.
El enfoque de la infografía observa CPU, RAM, disco, red, nodos y VMs. Prometheus recoge esas mediciones como series de tiempo; Grafana las presenta en paneles consultables y comparables.
2. Prometheus y Grafana: funciones diferentes
| Componente | Función | Pregunta que responde |
|---|---|---|
| Exporter | Expone métricas de Proxmox VE en un formato consultable | ¿Qué está ocurriendo en el origen? |
| Prometheus | Consulta, almacena y etiqueta series de tiempo | ¿Cómo ha cambiado el valor? |
| Grafana | Construye dashboards y consultas visuales | ¿Cómo lo interpreto? |
| Alertas | Evalúan condiciones y envían avisos | ¿Cuándo debo actuar? |
La imagen muestra Prometheus como sistema de monitoreo y Grafana como plataforma de visualización. La integración exacta depende del exporter y de las versiones utilizadas, por lo que debe validarse en el entorno real.
3. Métricas que conviene observar
- CPU: uso, saturación y tendencia por nodo y VM.
- RAM: consumo, presión y margen disponible.
- Almacenamiento: capacidad, latencia, errores y crecimiento.
- Red: entrada, salida, errores y pérdida de conectividad.
- Nodos: disponibilidad, estado del clúster y cantidad de nodos reportando.
- VMs y CTs: estado, carga y comportamiento de servicios críticos.
4. Preparar el entorno de laboratorio
La infografía propone una red de gestión o laboratorio 192.168.100.0/24 como ejemplo visual. No debe copiarse sin revisar el direccionamiento real. Se necesita conectividad entre Proxmox VE, el exporter, Prometheus y Grafana, además de control de acceso.
- Separa la red de gestión del tráfico público cuando el diseño lo permita.
- Usa nombres y etiquetas coherentes para nodos, VMs y servicios.
- Sincroniza la hora; las series de tiempo pierden valor si los relojes difieren.
- Protege las interfaces y limita quién puede consultar métricas.
- Define retención y capacidad para el histórico antes de ponerlo en producción.
5. Dos diagramas del ciclo de observabilidad
El primer diagrama representa la ruta de recolección y consulta.
El segundo muestra el paso de una medición a una respuesta operativa.
6. Los 12 pasos de la infografía
- Entender por qué monitorear: detectar problemas antes de que afecten servicios y usuarios.
- Identificar Prometheus: sistema que consulta y conserva métricas como series de tiempo.
- Identificar Grafana: plataforma para visualizar métricas mediante dashboards.
- Preparar el entorno: conecta Proxmox VE, Prometheus y Grafana en una red controlada.
- Instalar Prometheus: descarga, configura el archivo de scrape e inicia el servicio.
- Integrar Proxmox VE: instala y ejecuta un exporter y registra su endpoint en Prometheus.
- Verificar las métricas: comprueba que Prometheus recibe datos y que las series están activas.
- Instalar Grafana: inicia el servicio y accede a su interfaz web.
- Conectar Grafana con Prometheus: agrega Prometheus como fuente de datos y prueba la conexión.
- Crear el dashboard: organiza paneles de CPU, RAM, disco, red, nodos y VMs.
- Configurar alertas: define reglas para CPU, RAM, disco, nodo no disponible y servicios con problemas.
- Probar y validar: genera cargas controladas, recibe la alerta y confirma la métrica en ambas herramientas.
7. Diseñar dashboards que ayuden a decidir
Un dashboard operativo debe responder primero “¿está todo bien?” y después “¿dónde está el problema?”. Agrupa una vista general del clúster, una vista por nodo y otra para servicios críticos.
- Usa unidades claras: porcentaje, bytes, segundos o cantidad.
- Incluye periodo y frecuencia de muestreo visibles.
- Compara nodos para detectar desequilibrios.
- Evita decenas de paneles que nadie revisa.
- Incluye enlaces o instrucciones para el siguiente paso.
8. Umbrales, alertas y ruido
Un umbral aislado puede generar falsos positivos. Por ejemplo, CPU al 90 % durante diez segundos no significa lo mismo que CPU al 90 % durante quince minutos con latencia creciente. Las reglas deben considerar duración, contexto y severidad.
| Señal | Interpretación inicial | Respuesta sugerida |
|---|---|---|
| CPU alta sostenida | VM o nodo con demanda persistente | Identificar proceso, tendencia y capacidad |
| RAM crítica | Riesgo de presión o swapping | Revisar consumo, límites y distribución |
| Disco lleno | Riesgo para VMs, logs o backups | Detener crecimiento y aplicar plan de capacidad |
| Nodo sin métricas | Falla de conectividad o servicio | Comprobar red, exporter y disponibilidad |
Telegram, correo o webhook son canales; no sustituyen al procedimiento. Cada alerta debe indicar qué se detectó, desde cuándo y quién debe responder.
9. Ejemplo empresarial: anticipar saturación de almacenamiento
Una empresa observa en Grafana que el datastore de un nodo crece de manera constante. Prometheus mantiene el histórico y una regla avisa cuando el crecimiento proyectado comprometería la capacidad dentro de la ventana definida.
- El responsable recibe la alerta con nodo, datastore y severidad.
- Compara consumo de VMs, backups y snapshots para localizar el origen.
- Verifica si existe una tarea que se está ejecutando fuera de su retención.
- Libera espacio según la política y programa una ampliación, sin borrar manualmente datos protegidos.
- Confirma que la métrica vuelve a la zona esperada y documenta la causa.
El monitoreo no decide por sí solo qué borrar; aporta evidencia para que la decisión sea segura y reversible.
10. Ejercicio práctico
Diseña un dashboard para un clúster de tres nodos y doce VMs:
- Elige seis métricas iniciales y explica por qué.
- Define una alerta para disco crítico y otra para nodo sin reporte.
- Indica qué duración mínima usarías para evitar ruido.
- Describe una prueba controlada que no ponga en riesgo producción.
- Especifica qué evidencia conservarías después de recibir la alerta.
11. Buenas prácticas y errores frecuentes
Buenas prácticas
- Monitorear CPU, RAM, disco, red, nodos y VMs.
- Conservar históricos suficientes para ver tendencias.
- Definir umbrales con duración y severidad.
- Probar alertas con cargas controladas.
- Proteger endpoints, credenciales y canales de aviso.
- Revisar periódicamente dashboards y reglas.
Errores frecuentes
- Confundir dashboard verde con servicio saludable.
- Crear alertas para cada variación mínima.
- No sincronizar relojes.
- Exponer Prometheus o Grafana sin control de acceso.
- Monitorear solo el host y olvidar las VMs críticas.
- Recibir alertas sin definir quién actúa.
Preguntas frecuentes
¿Prometheus reemplaza los logs?
No. Prometheus almacena métricas numéricas; los logs aportan eventos y detalles textuales. Para diagnosticar un incidente suelen necesitarse ambos.
¿Grafana recoge directamente las métricas?
En este diseño Grafana consulta a Prometheus como fuente de datos. Prometheus es quien realiza la recolección desde el exporter.
¿Qué es un exporter?
Es un componente que expone información del sistema en un formato que Prometheus puede consultar. La implementación concreta para Proxmox VE debe elegirse y validarse según versión y seguridad.
¿Por qué una alerta puede no llegar?
Puede fallar la regla, el canal, la conectividad, la autenticación o el servicio de notificación. Por eso la infografía incluye una prueba controlada del monitoreo y de la alerta.
¿Cuántas métricas debo poner en el dashboard?
Las suficientes para decidir y diagnosticar la primera causa. Empieza por las métricas críticas y agrega detalle solo cuando exista una necesidad operativa real.
Conclusión
Prometheus y Grafana permiten convertir el estado de Proxmox VE en una historia observable: qué ocurre, desde cuándo, con qué intensidad y qué respuesta corresponde. La solución queda completa cuando las métricas son confiables, los dashboards son legibles, las alertas están probadas y cada aviso activa un procedimiento conocido.
Continúa con la Temporada 2
En EP022 aprenderás a proteger la infraestructura con el firewall de Proxmox VE.
Leer EP022 →