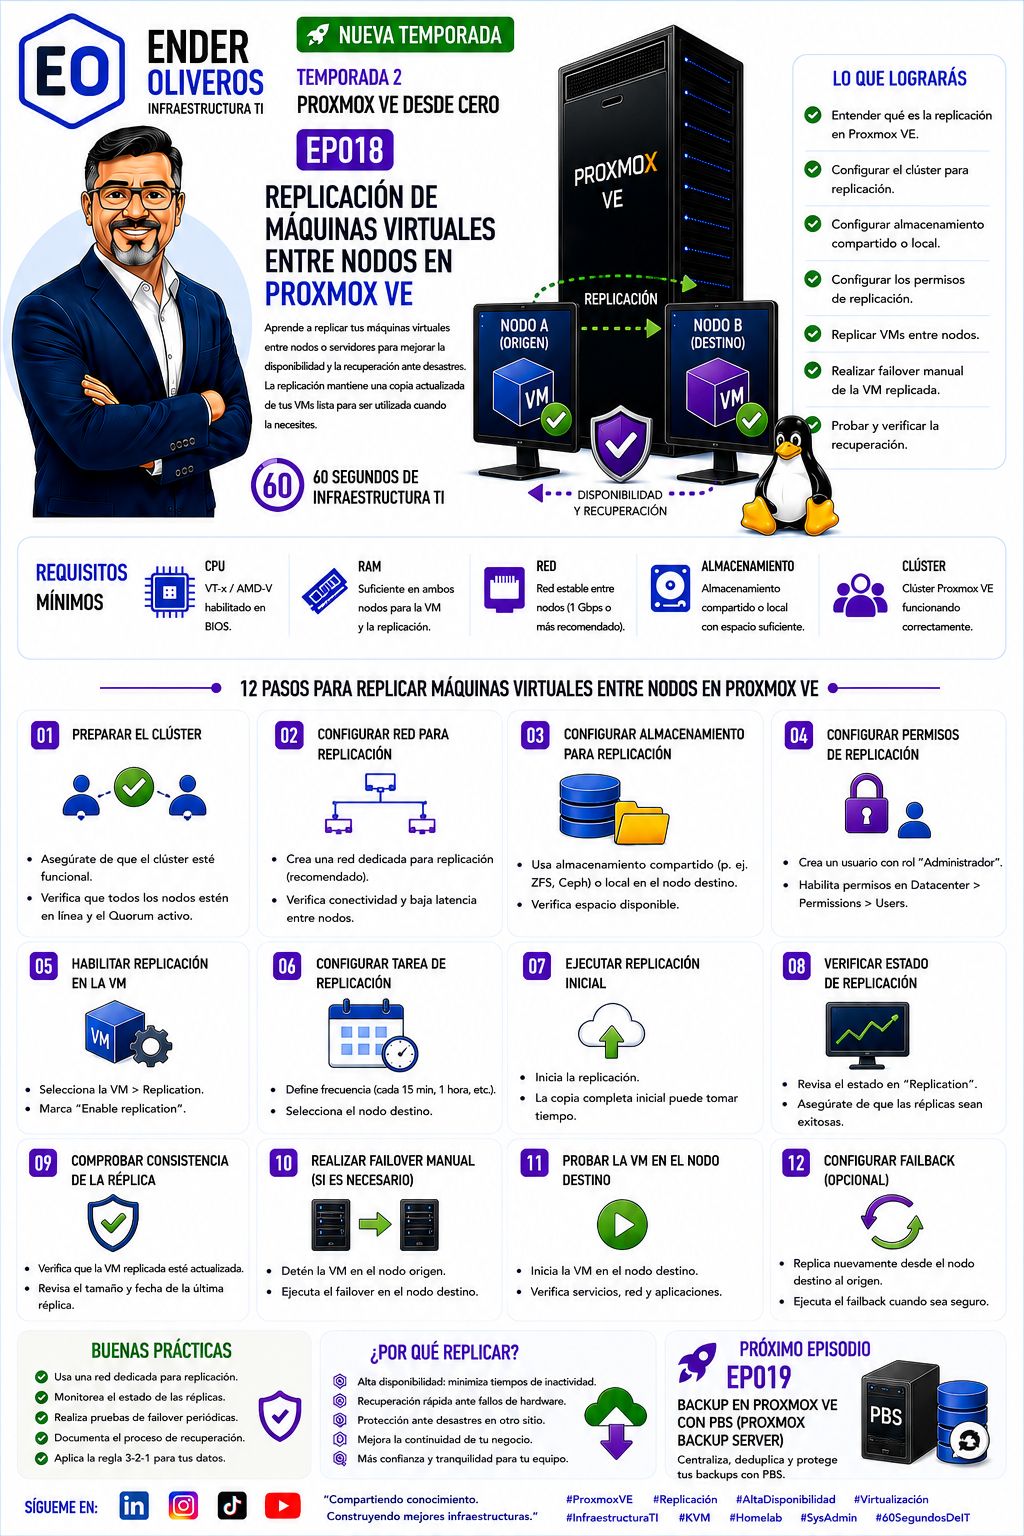
Replicar una máquina virtual significa mantener una copia de sus discos en otro nodo del clúster, actualizada según una tarea programada. Así, si el nodo de origen deja de estar disponible, el equipo puede activar la réplica en el destino y recuperar el servicio con menos tiempo de interrupción.
1. Qué es la replicación y qué problema resuelve
En el modelo de la infografía, el nodo A es el origen y el nodo B conserva la réplica. La primera ejecución crea una copia inicial; las siguientes transfieren los cambios detectados. La frecuencia de la tarea determina qué tan reciente puede estar la copia cuando ocurre una interrupción.
El objetivo no es tener dos VMs activas al mismo tiempo. Es disponer de una segunda representación preparada para ser iniciada de forma controlada. Por eso la replicación pertenece al diseño de continuidad y recuperación, no a la edición simultánea de una misma VM.
2. Replicación, backup, Live Migration y alta disponibilidad
Estos mecanismos se relacionan, pero responden preguntas distintas. Confundirlos produce expectativas incorrectas durante una emergencia.
| Mecanismo | Qué conserva o mueve | Cuándo se usa | Limitación principal |
|---|---|---|---|
| Replicación | Copia actualizada de discos en otro nodo | Recuperar rápido tras una falla del origen | Puede replicar también corrupción o borrado |
| Backup | Puntos históricos recuperables | Volver atrás, cumplir retención o responder a un desastre lógico | La restauración suele tardar más |
| Live Migration | Mueve una VM operativa | Mantenimiento planificado sin apagar el servicio | Requiere compatibilidad y conectividad durante el traslado |
| HA | Orquesta la recuperación de una carga | Reducir intervención manual ante fallas de nodo | Depende del clúster, quorum, almacenamiento y diseño |
3. Componentes que deben coordinarse
Una replicación fiable no depende de un único botón. Necesita que varias piezas estén alineadas:
- VM de origen: la carga que contiene el sistema operativo, aplicaciones y discos.
- Nodo destino: equipo que recibirá y almacenará la copia.
- Clúster: los nodos deben pertenecer a un clúster operativo y conservar quorum.
- Almacenamiento: puede ser compartido o local, según la tecnología y la configuración del clúster; debe existir espacio suficiente en el destino.
- Red de replicación: una red estable y, preferentemente, separada del tráfico de usuarios evita competir por ancho de banda.
- Tarea: define destino, frecuencia y estado de ejecución.
- Permisos: el operador necesita una cuenta con privilegios adecuados para crear y administrar la replicación.
4. Requisitos antes de crear la tarea
La infografía resume los mínimos: CPU con virtualización habilitada, RAM suficiente en ambos nodos, red estable —se recomienda 1 Gbps—, almacenamiento con capacidad y un clúster funcionando. En la práctica conviene añadir estas comprobaciones:
- Los nodos están en línea y tienen nombres, hora y versiones coherentes.
- Existe quorum; no se inicia una operación de recuperación sobre un clúster aislado o dividido.
- El destino puede ejecutar la VM: CPU compatible, memoria disponible y red preparada.
- La ventana de replicación no coincide con tareas que saturen discos o enlaces.
- Se conoce el procedimiento para detener el origen antes de activar el destino.
5. Dos vistas del flujo de replicación
El primer diagrama muestra el ciclo normal. La copia inicial puede ser grande; después se envían los cambios de cada intervalo.
El segundo diagrama representa una recuperación manual: primero se evita que existan dos instancias escribiendo a la vez; luego se inicia la réplica y se valida el servicio.
6. Los 12 pasos de la infografía
- Preparar el clúster: confirma que los nodos están conectados, en línea y con quorum.
- Configurar la red: crea una ruta estable y, si es posible, una interfaz dedicada para replicación.
- Configurar almacenamiento: elige almacenamiento compartido o local compatible y verifica espacio.
- Configurar permisos: utiliza un usuario con rol administrativo o permisos equivalentes en Datacenter > Permissions > Users.
- Habilitar la replicación en la VM: selecciona la VM, abre Replication y crea la configuración.
- Definir la tarea: elige nodo destino y frecuencia, por ejemplo cada 15 minutos o cada hora, según el RPO requerido.
- Ejecutar la replicación inicial: espera la primera copia completa; su duración dependerá del tamaño, disco y red.
- Verificar el estado: revisa que la tarea termine correctamente y que el destino aparezca actualizado.
- Comprobar consistencia: compara fecha, tamaño y estado de la última réplica; una tarea “terminada” no demuestra que la aplicación funcione.
- Realizar failover manual: ante una falla, detén la VM de origen si todavía responde y activa la réplica en el destino.
- Probar la VM destino: inicia la carga, revisa red, servicios, discos y dependencias.
- Configurar failback opcional: cuando el origen esté reparado y sea seguro, replica de vuelta y devuelve la operación siguiendo una ventana controlada.
7. Frecuencia, RPO y consistencia
La frecuencia no es un número decorativo. Si una VM se replica cada 15 minutos, la organización diseña una pérdida potencial de cambios de hasta ese intervalo, además del tiempo necesario para detectar el incidente y activar la copia. Si se programa cada hora, la ventana potencial es mayor.
La replicación de discos no equivale automáticamente a una copia transaccional de cada aplicación. Bases de datos, colas y servicios con escritura intensa pueden necesitar coordinación con el sistema invitado, pausas controladas o un backup específico. La verificación debe incluir el servicio, no solo el tamaño de los archivos.
8. Ejemplo empresarial: ERP en dos nodos
Una empresa mantiene su ERP en la VM ERP-01 del nodo PVE-A. PVE-B dispone de CPU y memoria suficientes, una red de replicación separada y almacenamiento con capacidad. La tarea se ejecuta cada 15 minutos.
- El equipo documenta que el RPO operativo es de 15 minutos y que el ERP requiere validación de base de datos después de un failover.
- Se realiza la sincronización inicial fuera del horario de mayor uso.
- Se prueba un failover planificado en una ventana de mantenimiento: se detiene ERP-01 en PVE-A, se activa en PVE-B y se comprueban DNS, autenticación, base de datos y acceso de usuarios.
- Se registra la hora de la última réplica, el tiempo de recuperación y cualquier diferencia observada.
- Tras reparar PVE-A, se replica de vuelta y se programa el retorno con responsables y plan de reversa.
La réplica reduce la interrupción por una falla del host, pero no reemplaza los backups históricos del ERP ni la protección frente a corrupción lógica.
9. Ejercicio práctico
Diseña la política para una VM de archivos de 300 GB, con dos nodos y una red de 1 Gbps:
- Elige una frecuencia y justifica el RPO.
- Indica qué revisarías en CPU, RAM, almacenamiento y red del destino.
- Escribe el orden de acciones para un failover sin dejar dos VMs activas.
- Define tres pruebas posteriores: conectividad, permisos y apertura de archivos.
- Explica cómo y cuándo harías el failback.
10. Buenas prácticas y errores frecuentes
Buenas prácticas
- Usar una red dedicada o priorizada para replicación.
- Mantener capacidad de RAM y almacenamiento en ambos nodos.
- Probar failover y failback periódicamente.
- Evitar lanzar muchas sincronizaciones pesadas al mismo tiempo.
- Aplicar la regla 3-2-1 con backups independientes.
- Documentar última réplica, responsables y plan de reversa.
Errores frecuentes
- Confundir réplica con backup histórico.
- Activar la VM destino sin confirmar el estado del origen.
- Usar una red saturada y asumir que la tarea siempre llegará a tiempo.
- Ignorar CPU, RAM o almacenamiento insuficientes en el destino.
- Declarar éxito porque se transfirieron discos sin probar la aplicación.
- Replicar corrupción o ransomware sin conservar copias aisladas.
Preguntas frecuentes
¿La replicación reemplaza los backups?
No. La réplica está pensada para una recuperación rápida y reciente; el backup conserva puntos históricos y debe mantenerse independiente para poder volver atrás ante corrupción, borrado o ransomware.
¿Puedo replicar hacia almacenamiento local?
La infografía contempla almacenamiento compartido o local con espacio suficiente. La posibilidad exacta depende de la tecnología de almacenamiento y del diseño del clúster; debe validarse antes de ponerlo en producción.
¿Qué ocurre si el nodo origen sigue encendido?
Antes del failover debes confirmar si la VM de origen está detenida o aislada. Tener dos instancias escribiendo los mismos servicios puede provocar conflictos y pérdida de consistencia.
¿La réplica protege frente a ransomware?
No por sí sola. Si los cambios maliciosos se replican, la copia puede quedar afectada. Combina replicación con backups con retención, separación de permisos y pruebas de restauración.
¿Qué diferencia hay entre failover y failback?
Failover es activar la copia en el nodo destino cuando el origen falla. Failback es devolver la operación al nodo original después de repararlo y sincronizarlo de forma controlada.
Conclusión
La replicación entre nodos convierte una segunda copia actualizada en una herramienta operativa de continuidad. Su valor aparece cuando el clúster, la red, el almacenamiento, los permisos, la programación y las pruebas se diseñan juntos. Un failover confiable no se improvisa: se practica, se documenta y se acompaña con backups independientes.
Continúa con la Temporada 2
Explora los episodios relacionados de Proxmox VE y vuelve a la temporada para seguir el recorrido.
Ver temporada →