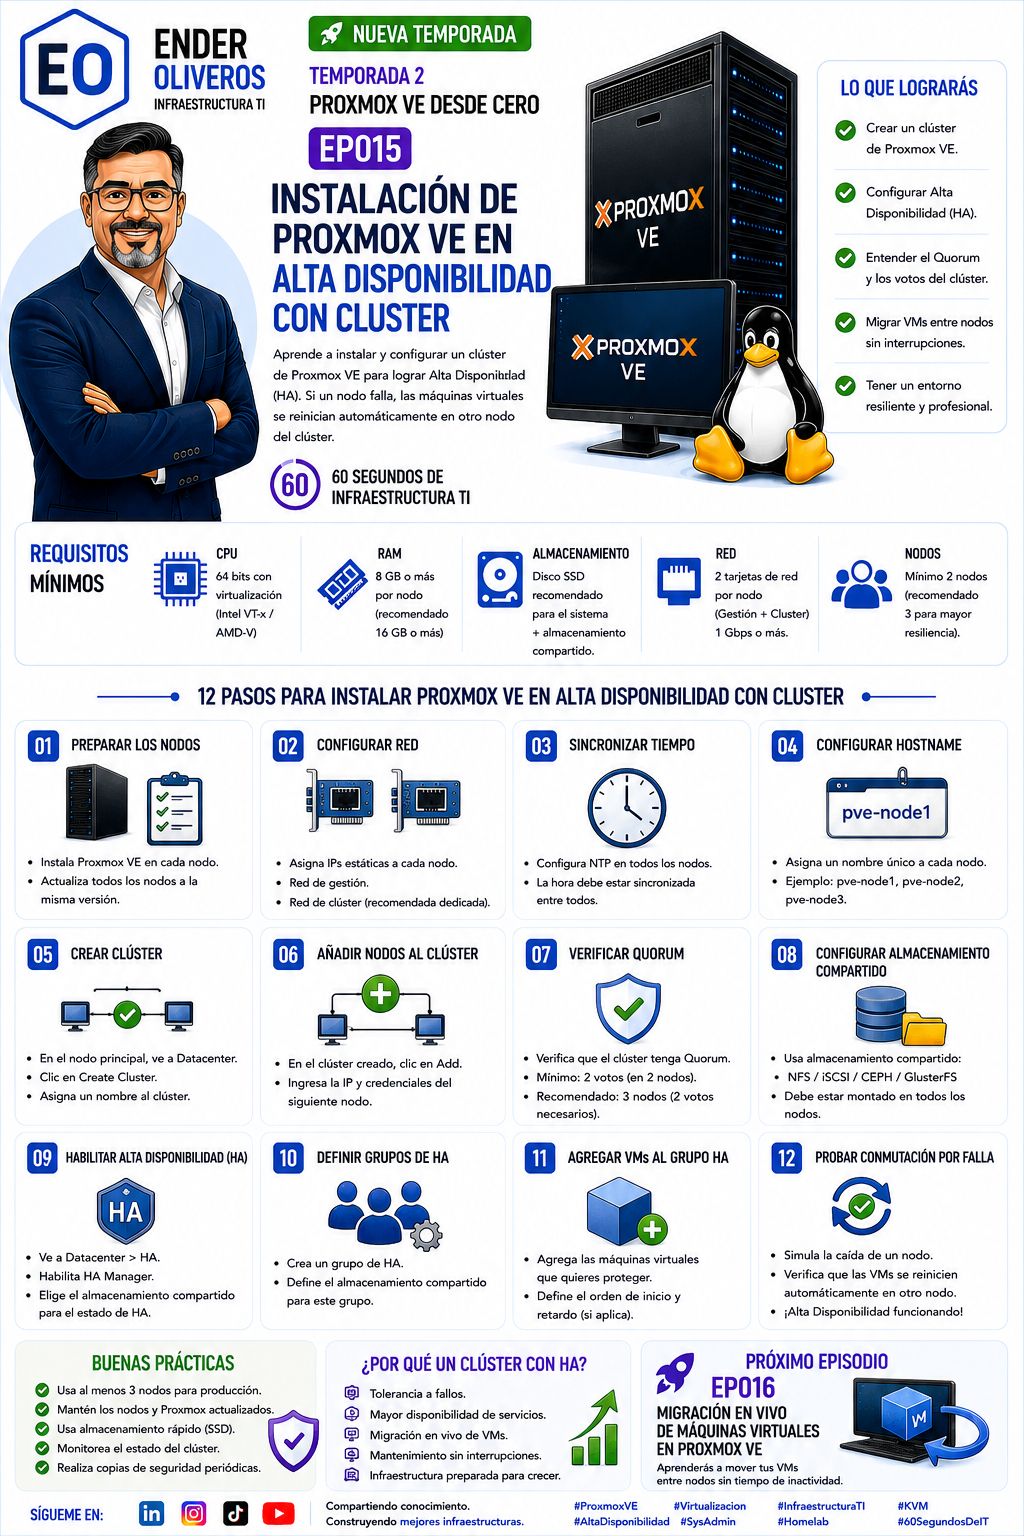
Un clúster de Proxmox VE agrupa varios nodos para administrarlos como un entorno coordinado. La alta disponibilidad añade una capacidad adicional: si un nodo falla, las VMs o contenedores configurados para HA pueden reiniciarse en otro nodo, siempre que existan quorum, recursos, almacenamiento y red adecuados.
1. Clúster y alta disponibilidad no son lo mismo
El clúster es la agrupación técnica de nodos con configuración y comunicación coordinadas. Permite administración centralizada y servicios compartidos del entorno.
La alta disponibilidad (HA) es la política que permite gestionar recursos —VMs o contenedores— para que puedan recuperarse en otro nodo cuando uno deja de prestar servicio. Es una función que se apoya en el clúster; no es sinónimo de “tener varios hosts”.
| Concepto | Pregunta que responde | Qué necesita |
|---|---|---|
| Clúster | ¿Qué nodos forman el entorno? | Identidad, red y comunicación confiable. |
| Quorum | ¿Hay suficientes votos para operar con seguridad? | Mayoría de votos y estado coherente. |
| HA | ¿Qué ocurre si falla un nodo? | Recursos HA, capacidad y almacenamiento accesible. |
| Failover | ¿Cómo se recupera una carga? | Reglas, tiempo de detección y destino disponible. |
2. Preparar los nodos
La infografía recomienda preparar al menos dos nodos y tres para mayor resiliencia. La documentación oficial de Proxmox indica que para HA se necesitan al menos tres nodos para un quorum confiable. Dos nodos pueden formar un clúster de laboratorio, pero su tolerancia a la pérdida de un nodo es limitada.
- Instalar una versión compatible de Proxmox VE en cada nodo.
- Usar hostname único: por ejemplo,
pve-node1,pve-node2ypve-node3. - Definir IPs estáticas y resolución de nombres consistente.
- Mantener firmware, paquetes y zona horaria alineados.
- Reservar CPU, RAM y almacenamiento para la carga que podría moverse.
3. Red de gestión y red de clúster
Corosync utiliza la red para intercambiar membresía y estado del clúster. No basta con que el panel web abra: la comunicación entre nodos debe ser estable, con baja latencia y sin pérdidas que provoquen decisiones erróneas de quorum.
En un diseño profesional, la gestión, Corosync, almacenamiento y tráfico de VMs pueden separarse mediante NICs, VLANs o redes dedicadas. La decisión depende del hardware y del nivel de criticidad.
4. Sincronizar tiempo y nombres
Todos los nodos deben compartir una hora coherente. La sincronización de tiempo ayuda a interpretar eventos, logs y tareas del clúster. También deben resolver correctamente los nombres de sus compañeros; un hostname duplicado o una resolución inconsistente puede impedir la formación del clúster.
- Definir nombres únicos antes de crear el clúster.
- Configurar NTP o el mecanismo de tiempo aprobado.
- Verificar resolución directa e inversa según la red.
- Comprobar conectividad entre todas las IP de Corosync.
5. Crear el clúster y añadir nodos
La infografía resume la operación desde Datacenter: crear el clúster en el primer nodo y añadir los demás usando la información de unión. Antes de unir un nodo, confirma que no tenga VMs o configuraciones que deban conservarse de forma independiente y realiza respaldo.
- Seleccionar el nodo inicial y crear un nombre de clúster.
- Registrar la información de conexión.
- Desde cada nodo adicional, validar hostname, IP, hora y versión.
- Usar la acción de unión y confirmar las credenciales solicitadas.
- Esperar a que la configuración se replique.
- Verificar que todos los nodos aparecen visibles y sanos.
6. Quorum: los votos que protegen la coherencia
El quorum es la mayoría necesaria para que el clúster considere válida su visión del estado. Evita que dos partes aisladas del entorno actúen simultáneamente como si fueran la autoridad. Si un nodo pierde quorum, el clúster puede limitar operaciones para proteger la configuración.
Por eso “dos nodos” no equivale a “dos votos suficientes para cualquier fallo”. En una plataforma crítica, tres nodos proporcionan una mayoría más robusta; un QDevice puede ser una alternativa en ciertos diseños, pero debe evaluarse y documentarse.
7. Almacenamiento compartido y HA
Para que una VM se reinicie en otro nodo, el destino debe tener acceso a su disco o a una copia utilizable. El almacenamiento compartido —por ejemplo NFS, iSCSI, Ceph o una solución compatible— facilita que varios nodos vean los recursos necesarios. La guía oficial de Proxmox describe estas opciones y sus implicaciones.
El almacenamiento local por sí solo no garantiza que una VM pueda arrancar en otro nodo. Puede combinarse con replicación u otros mecanismos, pero esa es una decisión posterior de arquitectura.
Qué revisar
- El storage aparece en todos los nodos que ejecutarán HA.
- Los permisos y contenidos son coherentes.
- La red de almacenamiento tiene capacidad suficiente.
- Existe espacio para reiniciar la carga en otro nodo.
8. Activar HA y crear grupos
Una VM no se vuelve altamente disponible por estar dentro del clúster. Hay que añadirla a la gestión HA y definir, si procede, un grupo con prioridades o restricciones. El grupo ayuda a expresar dónde debe ejecutarse primero y qué nodos son válidos.
- Seleccionar la VM o CT.
- Añadir el recurso a HA.
- Definir grupo, prioridad y orden de inicio si el diseño lo requiere.
- Comprobar el estado del recurso y del nodo.
- Documentar el comportamiento esperado ante fallo.
9. Prueba controlada de conmutación
La infografía propone simular la caída de un nodo. En producción, una prueba debe tener autorización, ventana, respaldo y un criterio claro de éxito. Nunca se debe desconectar un servidor crítico “para ver qué pasa”.
- Confirmar quorum y estado sano.
- Verificar que la VM pertenece a HA y tiene almacenamiento accesible.
- Registrar estado, servicios y usuarios afectados.
- Ejecutar una prueba controlada y observar la recuperación.
- Validar que la VM arranca en el nodo previsto y que sus servicios responden.
- Documentar tiempos, incidencias y plan de retorno.
10. Ejemplo empresarial
Una empresa tiene tres nodos Proxmox, una red dedicada para Corosync y un almacenamiento compartido. Su sistema de facturación corre en una VM configurada para HA. Durante el mantenimiento de un nodo, el equipo migra o reinicia la VM en otro nodo según el procedimiento, valida el servicio y mantiene el tercer nodo disponible para conservar quorum.
La continuidad no depende solo de Proxmox: también exige que la aplicación soporte reinicio, que la base de datos tenga su propia protección y que los usuarios sepan qué validar.
11. Ejercicio práctico
Diseña un clúster de laboratorio de tres nodos para una VM de aplicación:
- Asigna hostname e IP a cada nodo.
- Define qué red usarás para gestión y cuál para Corosync.
- Indica qué storage verá cada nodo.
- Explica cómo comprobarás quorum.
- Describe la prueba de fallo y la evidencia que guardarás.
12. Buenas prácticas y errores frecuentes
Buenas prácticas
- Usar al menos tres nodos para producción crítica.
- Separar o priorizar correctamente las redes.
- Sincronizar tiempo y resolver nombres antes de unir nodos.
- Probar failover con autorización.
- Monitorear quorum, storage y estado HA.
Errores frecuentes
- Crear un clúster con hostnames duplicados.
- Unir nodos con versiones incompatibles.
- Usar una red inestable para Corosync.
- Activar HA sin almacenamiento accesible.
- Confundir migración, réplica y HA.
Preguntas frecuentes
¿Puedo tener HA real con solo dos nodos?
Puede existir un clúster de dos nodos, pero la pérdida de uno deja una situación de quorum limitada. Para producción crítica, Proxmox recomienda al menos tres nodos para un quorum confiable.
¿HA evita toda interrupción?
No. Puede reducir el tiempo de recuperación, pero la VM debe reiniciarse, la aplicación debe tolerarlo y el almacenamiento y la red deben estar disponibles.
¿Necesito almacenamiento compartido?
Para muchos diseños de HA es la opción más directa, aunque existen arquitecturas con replicación u otras tecnologías. La decisión depende de la carga y del objetivo de recuperación.
¿Qué ocurre si se pierde quorum?
El clúster puede limitar acciones para evitar una operación incoherente. Debes recuperar la comunicación y revisar el estado antes de forzar cambios.
Conclusión
Un clúster Proxmox VE bien diseñado combina nodos preparados, red confiable, tiempo coherente, quorum, almacenamiento accesible y pruebas. La alta disponibilidad es un resultado operativo que se demuestra con una conmutación controlada, no una etiqueta que se activa en la interfaz.
Continúa con la Temporada 2
En EP016 veremos la migración en vivo de máquinas virtuales entre nodos.
Leer EP016 →